回归系数显著、R²也高,是否就能在论文里写“X导致Y”?在丘奖经济金融建模论文里,不能直接这样下结论。可操作的顺序是:先写清识别策略,再报回归结果;先说明遗漏变量、反向因果、测量误差中哪一条可能污染估计,再决定用工具变量、双重差分还是其他设计。据微信公众号「有方背景提升」2026年7月6日《金奖得主做对了什么?2025丘奖项目千字拆解:当中学生开始解决真实世界的问题……》对2025年丘奖经济金融建模金奖项目的拆解,该项目使用2015—2024年跨行业企业级招聘数据,结合OLS、工具变量与双重差分(DID)缓解内生性,分析人工智能对企业劳动需求、技能结构与工资极化的影响。这个例子说明方法要服务于识别问题,而不是给回归表堆方法。下文把识别策略拆成可在论文里逐项填写的自查页,并用明确标注的教学假设例说明每类方法应报告什么、不能声称什么。
一页纸识别策略:先写清来源,再写清处理
评委在答辩里问“这能说明因果吗”,往往不是在问回归系数大小,而是在问:你有没有说明估计量可能在哪个环节被污染,以及你用什么设计把污染降到可以接受的程度。写论文时不要先放回归表再补一段“内生性讨论”,而应在数据与变量部分之后单列“识别策略”小节。一页纸模板如下:
- 被解释变量与解释变量:用一句话说清核心系数想回答什么。
- 可能的内生性来源:从遗漏变量、反向因果、测量误差中选出主要的一条,并说明为什么它在本研究里重要。
- 识别设计:用固定效应、工具变量、双重差分、断点回归中的哪一种,各自依赖什么假设。
- 检查与降级:做了哪些检验;如果关键假设无法支撑,结论句如何从因果降级为相关或机制描述。
这张表的写法可以很朴素,但它决定了论文的结论语气。回归表负责报告估计值,识别策略负责说明这些估计值在多大程度上可以解释为因果。二者缺一,论文就容易被追问。
三类内生性来源,各配一个教学假设例
以下三个例子都是为说明报告逻辑而构造的教学假设例,不是真实赛题,也不是官方评分标准。
遗漏变量。假设研究“外卖平台评分对餐厅菜品价格的影响”。评分高的餐厅可能同时位于商业中心、客流量大、租金高,这些因素既推高评分也推高价格。若模型只放评分与价格,评分系数就可能吸收位置与客流的影响。报告时应明确列出可能遗漏的变量,并说明加入区域固定效应后系数是否稳定;但区域固定效应不能自动吸收所有客流差异,结论仍要保留边界。
反向因果或选址内生。假设研究“城市地铁新线路开通对周边商铺租金的影响”。地铁站选址本身可能倾向于租金已有上涨趋势的区域,因此不是“开通导致租金上涨”,而是“租金上涨预期推动选址”。报告时应说明线路规划的时间线,并检查开通前的租金趋势是否已经分化。这类情形可归入政策选址内生,不要只写成简单的反向因果。
测量误差。假设研究“学校引入AI辅助教学系统对学生成绩的影响”。若系统使用时长只来自学生自报,自报偏差与学习积极性相关,解释变量就带测量误差,系数可能被低估或高估。报告时应说明数据来源、是否有后台日志可以交叉验证,以及测量误差是否与结果变量相关。
三类问题不一定要全部解决,但论文必须说清主要威胁是哪一类,以及你用什么设计回应它。这里的写作原则可与丘奖论文数据分析怎么做?数据收集到结论全流程配合阅读。
工具变量:相关性、外生性与弱工具检查怎么报告
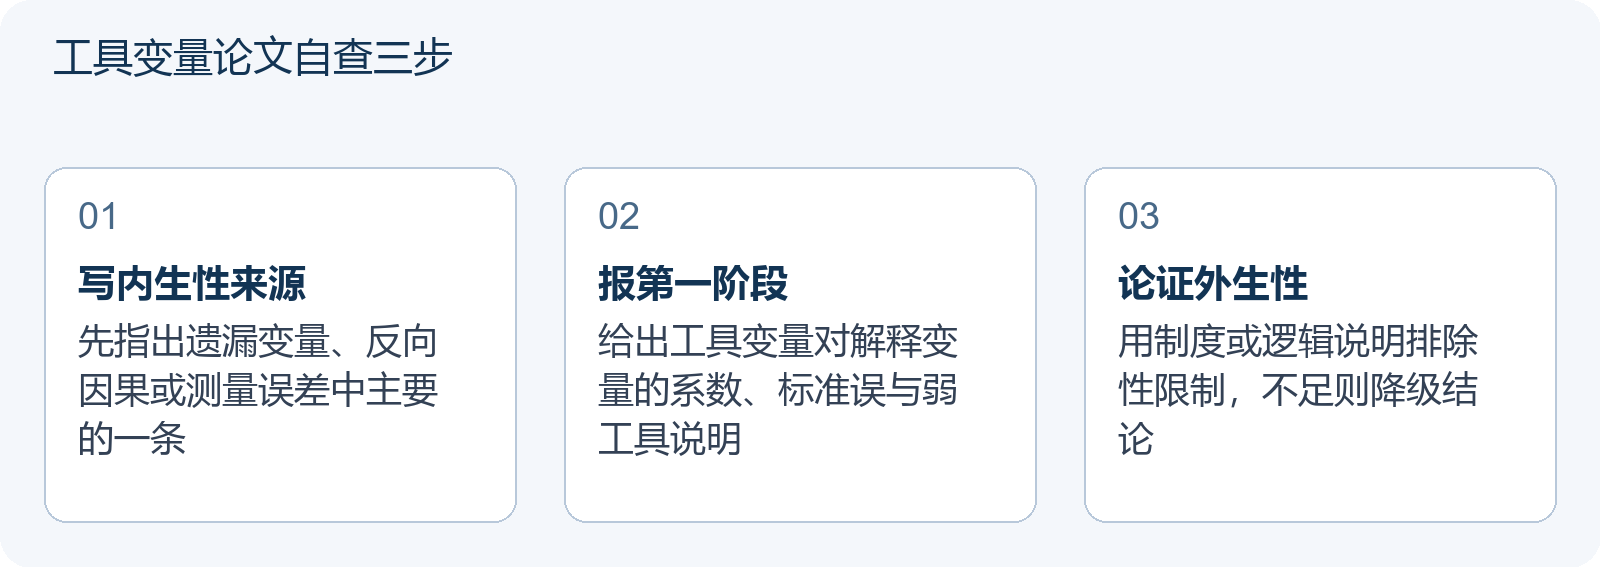
工具变量要同时满足两个条件:与解释变量相关,并且只通过解释变量影响结果。论文里不能只写“我们使用某工具变量缓解内生性”,而要分别报告。
相关性。报告第一阶段回归:工具变量对解释变量的系数、标准误与显著性。弱工具变量问题需要说明,不能只凭第一阶段显著就认为足够。若可用,报告第一阶段F统计量并说明采用的临界值来源;若样本较小或工具变量只有一个,应如实说明局限。
外生性。排除性限制通常无法用数据直接检验,需要制度、时间或逻辑论证。教学假设例:研究“最低工资上调对餐饮企业就业的影响”,用“邻近城市最低工资水平”作为工具变量。相关性可以论证为邻近城市政策影响本地政策讨论;排除性限制需要说明邻近城市工资不直接决定本地餐饮就业,只通过本地政策调整间接产生影响。若邻近城市与本地区域经济周期高度同步,或劳动力跨城通勤很强,邻近城市工资也可能直接影响本地就业,这一论证就会被削弱。
报告顺序。建议先写工具变量来源与制度背景,再报第一阶段,再报第二阶段,最后写排除性限制的论证与局限。不要只报第二阶段系数。若外生性无法支撑,结论应降级为“在工具变量假设成立时,估计结果与因果解释一致”,而不是直接写“证明X导致Y”。
DID:平行趋势、事件研究图与处理组构造怎么写
双重差分依赖处理组与对照组在处理前具有可比趋势。论文里至少应报告以下内容。
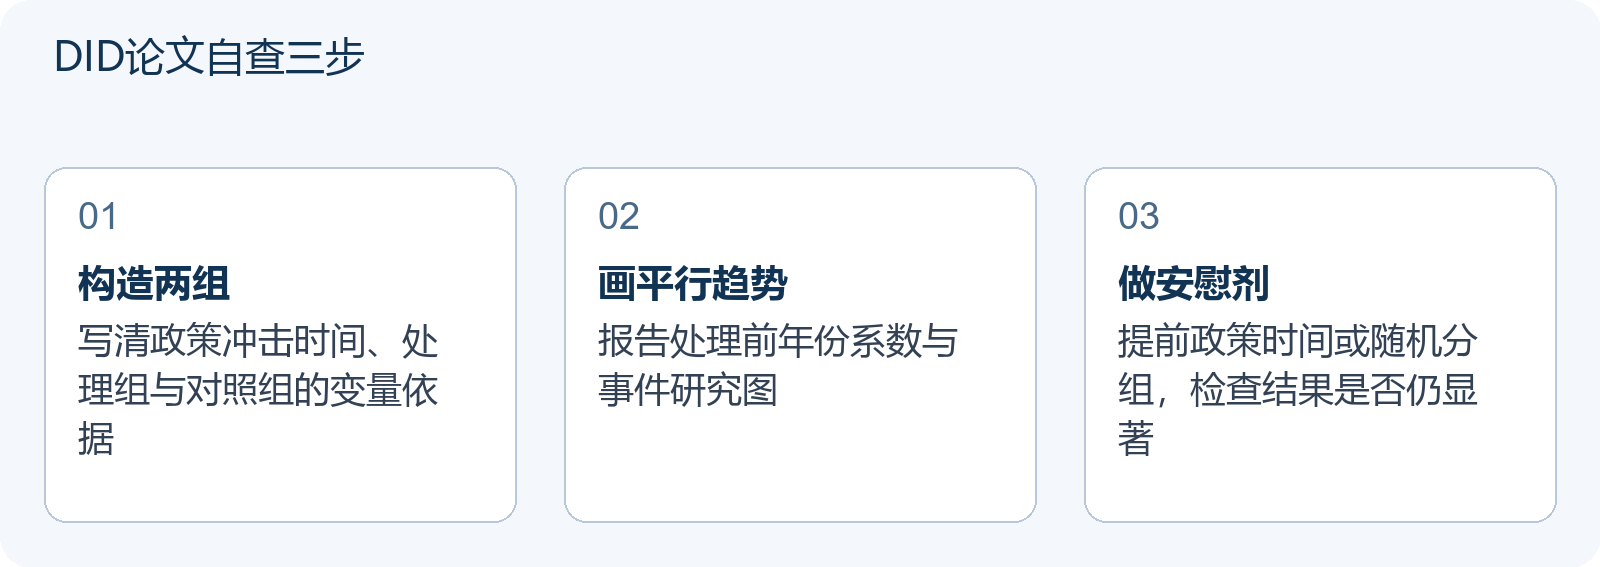
处理组与对照组构造。说清政策冲击的时间、覆盖范围与分组依据。教学假设例:假设一项2015年实施的环境规制作为冲击,把受约束较强的行业设为处理组,受约束较弱的行业设为对照组。分组标准要能落在数据变量上,不能只凭叙事。
平行趋势检验。报告处理前的年份虚拟变量与处理组交互项,若处理前系数接近零且不显著,平行趋势更可信;若处理前已经分化,应说明可能的替代解释,并考虑加入行业趋势或匹配后重新估计。
事件研究图。把每一年相对冲击年份的处理效应画出来,让读者看到处理前系数与处理后系数的变化。图的横轴是相对年份,纵轴是估计系数与置信区间,图注要写清参照期与聚类层级。
聚类与稳健性。面板数据可考虑在行业或地区层面聚类标准误,并说明聚类数量的局限。若处理组数量很少,应如实说明推断精度受限,而不是只报星号。
这些报告内容与丘奖统计显著性怎么报告?p值、效应量与置信区间自查中的统计报告思路一致:DID不能只给一个显著系数,要给读者看到趋势与不确定性。
安慰剂检验与稳健性:换样本、换度量、排除竞争解释
安慰剂检验的作用是检查“如果处理其实没有发生,模型会不会仍然给出显著结果”。可用三类做法。
- 时间安慰剂:把政策时间提前若干年,若仍得到显著“效应”,说明原结果可能来自趋势而非政策。
- 分组安慰剂:把处理组标签随机分配给不应受政策影响的单位,重复多次,观察真实估计是否落在随机分布的尾部。
- 结果安慰剂:换一个理论上不应受政策影响的结果变量,若仍显著,应检查模型或样本是否存在共同趋势问题。
稳健性检查则围绕替代解释展开:换样本期间、换被解释变量度量、换控制变量集合、换固定效应层级,观察核心系数的方向与量级是否稳定。论文里不需要把所有检查都堆上去,但应选择与主要内生性威胁直接相关的两三项,并解释为什么做这几项。表与图的安排可参考丘奖文献比较:用同一评价标准说明自己的增量贡献中关于比较口径的思路。
答辩追问:评委问“政策或平台规则外生吗”时的回答顺序
答辩时不要急着重复回归系数。可以按以下顺序回答。
- 先确认问题的层次:评委问的是识别假设,不是结果大小。
- 说明本研究主要担心的内生性来源是哪一条,以及为什么选这个设计。
- 报告关键假设的检查结果,包括第一阶段、平行趋势、安慰剂检验中做了哪些。
- 明确假设不成立时结论如何降级:哪些表述是因果,哪些只能写成相关或机制。
- 说明数据或设计上的局限,以及如果继续研究会在哪一步补证据。
这套顺序可以概括为“先假设、后证据、再边界”;重点是把内生性检查结果提前写进论文,而不是到答辩才临时组织。
结论措辞:从因果降级为相关、机制与边界条件
论文结论句应与识别强度匹配。可以准备三档措辞。
- 强识别:相应识别假设,例如工具变量的排除性限制或DID的平行趋势,有充分论证与针对性检验支撑。可写“估计结果支持X对Y的因果影响”,同时保留假设条件。
- 中等识别:固定效应加控制变量,但无法完全排除遗漏变量。可写“在控制若干可观测因素后,X与Y呈稳健相关,结果与因果解释一致”。
- 弱识别:只有横截面相关或工具变量论证不足。应写“X与Y相关,但本研究不能区分因果方向”,并把机制讨论标为推测。
降级不是削弱论文,而是让读者知道结论的适用范围。相反,把相关结果写成因果,才是答辩里容易被追问的写法。论文中还可以增加“边界条件”一段,说明样本期间、行业范围或制度环境改变后结论可能如何变化。
自查清单与备赛诊断:带回归表与识别段做一次核对
提交前可以用下面这张表逐项核对。
| 检查项 | 论文中应看到 | 常见缺口 |
|---|---|---|
| 内生性来源 | 明确指出主要威胁并说明为什么重要 | 只写“存在内生性” |
| 工具变量 | 第一阶段、外生性论证、弱工具说明 | 只报第二阶段 |
| DID | 分组依据、平行趋势、事件研究图 | 只报交互项系数 |
| 安慰剂 | 至少一类与主要威胁相关的检验 | 把所有检验堆上去但不解释 |
| 结论措辞 | 与识别强度匹配,保留边界条件 | 一律写“证明因果” |
自查时可准备三样材料:研究问题一句话、核心回归表、识别策略段与结论句草稿。按“来源—设计—检查—措辞”四步核对,比只讨论“方法够不够高级”更能发现论文中的缺口。从备赛教学角度,建议把问题、数据与识别的匹配放在方法名称之前;这一判断是教学建议,不是官方评分细则。
一般活动背景信息可参见赛事背景资料。
常见问题
回归结果显著但没处理内生性,论文里能写“因果影响”吗?
一般不建议。显著系数只说明样本中的相关关系;若没有说明遗漏变量、反向因果或测量误差,结论句应写成相关,并说明识别局限。把相关写成因果,答辩时容易被追问,也不符合论文自身的证据强度。
工具变量和DID可以同时用在一篇论文里吗?
可以,但要看研究问题是否需要。2025年丘奖经济金融建模金奖项目在同一研究中结合了OLS、工具变量与双重差分来缓解内生性(来源:微信公众号「有方背景提升」,2026年7月6日)。关键是分别写清每个设计依赖的假设与检查结果,而不是把方法名称并列就算完成识别。
安慰剂检验要做几项才够?
没有固定数量。应选择与主要内生性威胁直接相关的一至两类,例如时间安慰剂或随机分组安慰剂,并解释为什么做这一项、结果说明什么。把所有检验堆上去但不解释,反而不如两项针对性检查清楚。